сделать предпочтительным
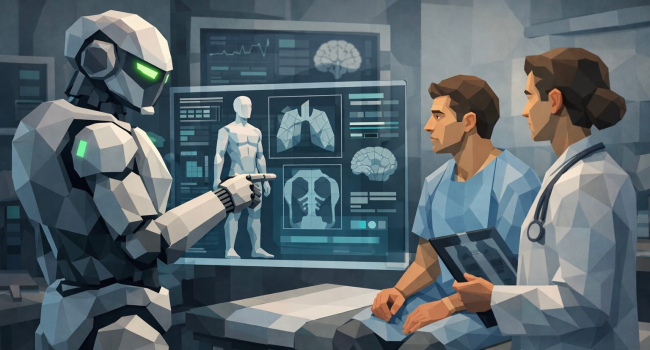
Согласно новому исследованию, модели искусственного интеллекта показали более высокие результаты, чем врачи, при принятии медицинских решений в условиях неотложной помощи.
Учёные Гарвардской медицинской школы и Медицинского центра Бет Исраэл Диконесс в США сравнили работу искусственного интеллекта и врачей в широком спектре задач, связанных с клиническим мышлением.
Они выяснили, что крупные языковые модели (LLM) превосходят врачей по целому ряду задач, в том числе при принятии решений в отделении неотложной помощи на основе имеющихся данных, определении наиболее вероятных диагнозов и выборе дальнейшей тактики ведения пациента.
«Мы проверили модель ИИ практически по всем возможным критериям, и она превзошла как предыдущие версии, так и наши врачебные показатели», — рассказал Арджун Манрай, со‑руководитель исследования и профессор Гарвардской медицинской школы.
«Однако это не означает, что ИИ автоматически улучшит качество помощи: то, как и где его следует применять, всё ещё изучено недостаточно, и нам крайне необходимы строгие проспективные исследования, чтобы оценить влияние ИИ на клиническую практику», передает Euronews.
Сначала исследователи оценили o1-preview, модель рассуждений компании OpenAI, выпущенную в 2024 году, которой предложили ряд клинических случаев, включая опубликованные разборы и реальные истории пациентов из отделений неотложной помощи.
ИИ превзошёл врачей в большинстве экспериментов, особенно в части обоснования тактики ведения, клинического мышления, ведения документации и работы в реальных условиях отделения неотложной помощи при ограниченном объёме информации.
«Модели становятся всё более способными. Раньше мы оценивали их с помощью тестов с выбором ответа, теперь же они стабильно набирают почти 100 %, и мы больше не можем отслеживать прогресс, потому что уже упёрлись в потолок», — сказал соавтор исследования Питер Бродёр, клинический научный сотрудник Гарвардской медицинской школы и врач-терапевт в Медицинском центре Бет Исраэл Диконесс.
В одном из тестов исследователи попросили языковые модели — o1 и GPT-4o — оценивать состояние пациентов на разных этапах стандартного маршрута в отделении неотложной помощи, от ранней сортировки до решения о госпитализации.
На каждом этапе модели предоставляли только ту информацию, которая была доступна в данный момент, и просили указать вероятные диагнозы и рекомендовать дальнейшие действия.
Наибольший разрыв между ИИ и врачами наблюдался на этапе сортировки, когда информация о пациенте наиболее ограничена.
Как и у врачей, по мере появления дополнительной информации у моделей ИИ улучшалась диагностическая точность.
«Хотя применение ИИ для поддержки клинических решений иногда рассматривается как рискованное направление, более широкое использование таких инструментов может помочь снизить человеческие и финансовые потери из-за диагностических ошибок, задержек и отсутствия доступа к помощи», — пишут авторы.